用文字指挥镜头
在提示词里写「缓慢推轨向前」「手持跟拍」或「航拍拉远」。AI 视频生成器会把运镜当作场景的一部分,而不是事后加的特效。
用平常的话描述一个镜头,把想法变成成片。选好主体、动作、镜头和氛围,剩下的交给 ReelCine 生成带运动和可选原生音频的场景。
生成需要账号,并按你选择的模型、时长和分辨率消耗积分。失败的任务会自动退款。
每个示例最初都是文字。读提示词、看它的首帧,再播放完整的 AI 视频,看看写下的指令是怎么变成运动的。
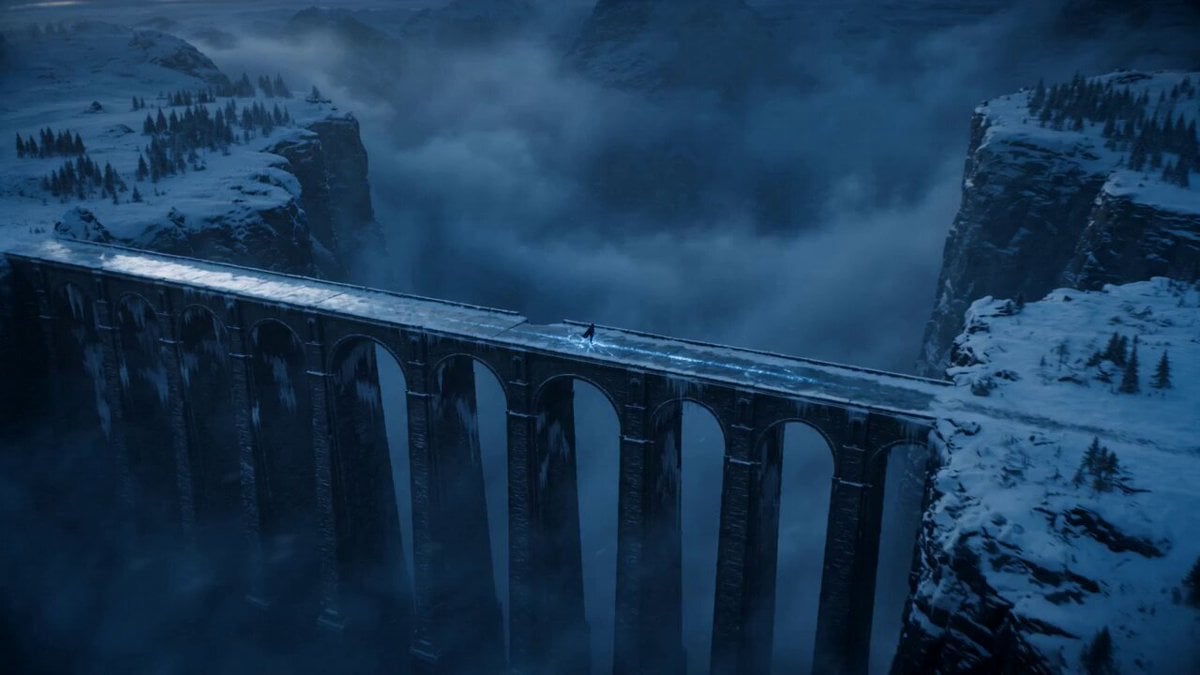 首帧
Duration: 15 seconds Style: Ultra-realistic cinematic, dark fantasy, hyper-realistic, 9:16 vertical, 8K, 60fps. 0–3s: A wide aerial shot reveals an ancient frozen stone bridge stretching over a bottomless icy canyon during blue hour. Snow falls steadily as blizzards sweep across distant mountains. Cracked ice glows with mysterious blue runes beneath the warrior's feet. Cinematic drone push-in. 3–7s: The camera slowly circles behind a mysterious hooded warrior standing motionless on the bridge. A tattered black cloak whips violently in the freezing wind. Ultra-detailed medieval armor glistens with frost while a glowing silver sword reflects the icy surroundings. Volumetric fog drifts through the canyon. 7–11s: A low-angle tracking shot moves toward the warrior as they slowly raise the enchanted sword. The blue runes pulse brighter across the frozen bridge, snow swirls dramatically around the cloak, and distant lightning briefly illuminates the storm clouds and snow-covered peaks. 11–15s: The warrior takes one powerful step forward. A shockwave of glowing blue energy races through the ancient runes beneath the ice, sending sparkling frost across the bridge. The camera rapidly pulls back into a breathtaking aerial view as the blizzard intensifies, ending on an epic cinematic wide shot with the lone warrior standing against the frozen wilderness.
可以从一句话开始,也可以描述一整段序列。文生视频模型会把主体、场地、运动、镜头语言、光线和声音当作一个连贯的场景来理解。
在同一个工作区里比较主流的文生视频模型。先用 Seedance 2.0 Mini 出一版便宜的草稿,等场景需要更真实、更快的运动、更长的时长或原生音频时再换模型。
生成器把创作决定留给你,中间那些帧交给 AI。
在提示词里写「缓慢推轨向前」「手持跟拍」或「航拍拉远」。AI 视频生成器会把运镜当作场景的一部分,而不是事后加的特效。
不需要素材,也不需要起始图。写清主体、它在做什么、环境如何反应,文生视频模型就会按提示词逐帧搭建画面。
同一个想法可以做成宽幅电影镜头、社交平台的竖屏视频或方形帖子。生成前先定好比例,构图才是照着最终画幅长出来的。
支持的模型会把环境音、音效和对白和画面一起产出。原生音频让雨声、脚步、人声和看得见的动作保持对齐,不用再单独走一遍剪辑。
从空白的提示词框到可下载的片段,三个清晰的步骤。
写清出现的是谁或什么、场景发生在哪里、主要动作是什么。只有在真的影响结果时,才加上运镜、光线或风格。
选一个文生视频模型,以及时长、分辨率和比例。先用 480p 的短草稿验证想法,再把积分花在更长的成片上。
启动任务,在「我的作品」里跟进度。播放结果,需要的话换个模型再跑同一条提示词,然后下载无水印的成片。
当想法很清楚、但实拍会很慢、很贵或根本做不到时,文生视频最有用。
在正式产品拍摄之前,把一个 campaign 想法变成会动的概念画面。试场景、试运镜、试节奏,把最扎实的那版当作广告 brief 或可直接发布的片段。
为 Reels、Shorts 和抖音生成竖屏钩子、氛围循环和视觉叙事。开头写一个具体的动作,AI 视频在前几秒就有东西可看。
写下一个难拍的运镜或动作瞬间,在开机前先看到画面。导演和创意可以比较不同解读,不用先订场地、演员和特效团队。
描述手绘世界、定格微缩模型或图形化的 3D 序列,不必先画一张参考帧。整条提示词里保持风格用词一致,片段会更整。
做出实拍不现实的天气现象、地貌、宇宙环境和幻想建筑。写上尺度、时间和环境的运动,场景才会在物理上说得通。
把一个抽象概念变成演讲、落地页或教学视频里的短序列。描述一个能读懂的比喻,别把几个不相干的点硬塞进一个片段。
看看真实的提示词和它们生成的结果。选一个示例,它的文字会载入生成器,然后你把主体、动作或运镜改成自己的场景。
积分消耗在生成前就会显示,随模型、时长和分辨率变化。先用短草稿试提示词,只在值得做完的那版上多花积分。
文生视频 AI 生成器根据一段文字描述生成一串运动的画面。提示词可以定义主体、场地、动作、运镜、光线和视觉风格。它不是从素材或上传的图片出发,而是由模型搭建场景,并预测它随时间如何变化。
可以。打开生成器、浏览示例、准备提示词都不用付费。新账号会获得足够跑几次短生成的入门积分。准确的积分消耗会在任务开始前显示在生成按钮上,那时你还能改模型、时长或分辨率。
不用。图片栏留空,就会作为文生视频任务提交。如果你加了起始图,同一个界面会自动切换成图生视频。两条路径共存,不需要你一开始就选一个技术模式。
先写主体和主要动作,再补上环境和一个运镜指令。比如:「一只赤狐在黎明的新雪上行走,呼出的白气可见,低角度跟拍,柔和自然光。」具体的画面指令比一长串感觉词更容易被执行。只有当所选模型支持原生音频时,才写对白或声音。
默认是 Seedance 2.0 Mini,因为它适合 480p 的快速廉价草稿。其他模型在高分辨率、人物运动、电影感真实度、更长片段或原生音频上可能更合适。把同一条提示词在几个模型上都跑一遍,通常比找一个「万能最优」学到得更多。
可选时长取决于模型。ReelCine 的模型覆盖从社交短片到十几秒的场景,支持的范围会显示在时长控件里。调动作的阶段用四五秒就够。等运动和构图都对了,再把成片加长,或换一个支持更长时长的模型。
所选模型支持原生音频时可以。生成器能在输出画面的同时请求环境音、音效和对白,这有助于让看得见的动作保持同步。不支持音频的模型输出无声视频;如果你打算自己配乐或配音,也可以把音频关掉。
可以。竖屏的 Shorts、Reels 和抖音选 9:16,宽幅视频选 16:9,或者选所用模型支持的其他比例。生成前定比例很重要,因为模型是照着那个画幅来安排人物、物体和运镜的,而不是事后从宽画面里裁一块。
不带。生成的片段下载时没有 ReelCine 水印。用作灵感的示例在放上这个页面之前也都检查过,所以你看到的效果和生成器承诺的干净输出是一致的。
视频模型要在所有帧上平衡很多条指令,所以互相冲突的动作或风格会削弱结果。把提示词收敛到一个清楚的事件,说明什么要保持不变,并且只用一个运镜。如果第一版偏了,改一条具体指令,而不是一次加好几个新形容词。
渲染时间随模型、时长、分辨率和供应商负载变化。短草稿比高分辨率长片段快。你不用一直开着生成器:提交的任务会继续跑,完成后出现在「我的作品」和生成历史里。
商用与否取决于你的套餐和当前的服务条款。你也要为提示词里要求的名字、角色、商标和其他素材负责。用原创的主体和概念,是让文生视频作品保持可发布状态最省事的办法。